Nếu Post-Training Quantization (PTQ) giống như việc bạn đào tạo một vận động viên chạy marathon ở điều kiện lý tưởng, rồi ngay trước giờ thi đấu lại buộc thêm tạ vào chân họ, thì Quantization-Aware Training (QAT) chính là việc cho vận động viên đó tập luyện cùng tạ ngay từ trên sân tập. Khi ngày thi đấu chính thức bắt đầu, cơ thể họ đã tự điều chỉnh nhịp thở và sải chân để đạt tốc độ tối đa bất chấp trọng lượng tăng thêm.
Trong kỹ thuật Trí tuệ nhân tạo, QAT là phương pháp tối ưu nhất để giữ lại trí thông minh của mô hình khi ép xuống các định dạng siêu nhẹ như INT4, INT3, hay thậm chí là 1.58-bit. Bài viết này sẽ đi sâu vào cơ chế toán học đằng sau QAT và quy trình từng bước để bạn có thể tự tay huấn luyện một mô hình QAT thực tế.
Bí mật bên trong QAT: Vượt qua “bức tường” đạo hàm
Để hiểu cách train QAT, trước tiên chúng ta phải nhìn vào rào cản toán học lớn nhất của nó. Mạng nơ-ron học bằng thuật toán lan truyền ngược (Backpropagation) và tối ưu hóa dựa trên đạo hàm (Gradient Descent). Tuy nhiên, phép lượng tử hóa cốt lõi lại dựa trên hàm làm tròn số nguyên (round()).
Hàm làm tròn là một hàm bậc thang: đạo hàm của nó bằng $0$ ở hầu hết mọi điểm, và không xác định tại các bước nhảy. Nếu bạn đưa thẳng hàm round() vào mạng nơ-ron trong lúc huấn luyện, gradient sẽ lập tức triệt tiêu về $0$ và mô hình ngừng học hoàn toàn.
Để giải quyết bài toán này, QAT kết hợp hai kỹ thuật kinh điển:
1. Fake Quantization (Lượng tử hóa giả lập) ở lượt truyền xuôi (Forward Pass)
Trong suốt quá trình train QAT, các trọng số gốc (master weights) vẫn được lưu trữ và cập nhật ở định dạng số thực chính xác cao (FP32 hoặc BF16).Tuy nhiên, trước khi thực hiện phép nhân ma trận ở mỗi lớp mạng, dữ liệu sẽ đi qua một nút gọi là FakeQuantize:
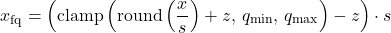
Trong đó $s$ là hệ số tỷ lệ (scale) và $z$ là điểm gốc (zero-point). Công thức này chuyển số thực sang lưới số nguyên rời rạc rồi lập tức giải mã ngược lại thành số thực. Kết quả là giá trị $x_{\text{fq}}$ vẫn mang kiểu dữ liệu số thực, nhưng đã chứa đúng sai số làm tròn giống hệt như khi chạy trên phần cứng số nguyên thật. Nhờ đó, hàm mất mát (loss function) tính toán được chính xác mức độ thiệt hại do việc nén gây ra.
2. Straight-Through Estimator (STE) ở lượt truyền ngược (Backward Pass)
Khi tính đạo hàm để cập nhật trọng số gốc, cơ chế STE sẽ tạm thời “bỏ qua” tính chất bậc thang của hàm round(). Nó xấp xỉ đạo hàm của phép làm tròn bằng $1$ trong dải giá trị hợp lệ $[q_{\min}, q_{\max}]$ và bằng $0$ nếu vượt ra ngoài ngưỡng cắt (clamp):
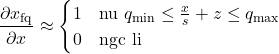
Nhờ STE, gradient đi xuyên qua các nút FakeQuant một cách trơn tru để điều chỉnh các trọng số gốc, hướng mô hình hội tụ về những vùng cực tiểu phẳng (flat minima)—nơi mà một chút sai số làm tròn không làm thay đổi dự đoán đầu ra.
Quy trình 5 bước để huấn luyện QAT thực chiến
Trong thực tế, hầu như không ai huấn luyện QAT từ con số 0 (ngoại trừ các kiến trúc đặc thù như BitNet) vì chi phí tính toán quá lớn. Thay vào đó, các kỹ sư áp dụng Quantization-Aware Fine-Tuning theo 5 bước tiêu chuẩn sau:
Bước 1: Chuẩn bị mô hình gốc đã hội tụ (Pre-trained Baseline)
Bạn luôn bắt đầu từ một mô hình đã được huấn luyện hoàn chỉnh ở độ chính xác cao (FP32 hoặc BF16). Trước khi làm QAT, hãy thử chạy PTQ trên mô hình này để lấy một điểm chuẩn (baseline) về độ chính xác và tốc độ.QAT chỉ thực sự cần thiết khi kết quả từ PTQ bị sụt giảm vượt quá ngưỡng cho phép của bài toán.
Bước 2: Biến đổi đồ thị mạng & Chèn nút FakeQuant (Prepare)
Hệ thống sẽ duyệt qua kiến trúc mạng nơ-ron để thực hiện hai việc:
- Gộp lớp (Layer Fusion): Với các mạng thị giác máy tính (CNN), các lớp liên tiếp như
Conv2d + BatchNorm2d + ReLUsẽ được gộp làm một khối duy nhất để loại bỏ sai số làm tròn trung gian giữa các lớp. - Chèn bộ quan sát (Observers) và FakeQuant: Các lớp tuyến tính (
nn.Linearhoặcnn.Conv2d) được thay thế bằng phiên bản QAT tương ứng. Cấu hình lượng tử hóa ở bước này phải khớp hoàn toàn với phần cứng triển khai sau này—ví dụInt4WeightOnly(trọng số 4-bit, kích hoạt BF16) cho máy chủ GPU, hoặcInt8DynamicActivationInt4Weightcho chip di động.
Bước 3: Khởi động Observer (Calibration / Warm-up)
Trước khi cập nhật trọng số, mô hình thường chạy qua một vài batch dữ liệu mẫu để các Observer ghi nhận biên độ giá trị nhỏ nhất/lớn nhất (min/max) của trọng số và giá trị kích hoạt. Từ đó, hệ thống tính toán được bộ tham số scale ($s$) và zero-point ($z$) ban đầu hợp lý nhất, tránh tình trạng sốc gradient ở những bước học đầu tiên.
Bước 4: Vòng lặp tinh chỉnh QAT (QAT Fine-tuning Loop)
Mô hình được huấn luyện tiếp trên tập dữ liệu thực tế (thường chỉ cần khoảng 5% đến 10% số bước huấn luyện ban đầu):
- Giai đoạn đầu: Cả trọng số gốc lẫn các tham số lượng tử hóa (
scale,zero-point) đều được cập nhật liên tục để mô hình làm quen với nhiễu làm tròn. - Giai đoạn cuối (Đóng băng Observer): Ở những epoch cuối cùng, kỹ sư thường khóa cố định giá trị
scale,zero-pointvà thống kê củaBatchNorm. Việc này giúp lưới lượng tử hóa đứng yên hoàn toàn, cho phép các trọng số tinh chỉnh lần cuối để khớp khít vào các mốc số nguyên cố định.
Bước 5: Chuyển đổi sang mô hình số nguyên thực thụ (Convert & Export)
Sau khi kết thúc huấn luyện, mô hình vẫn đang chứa các nút FakeQuant chạy trên số thực. Ở bước Convert, hệ thống sẽ loại bỏ toàn bộ nút giả lập, ép cứng trọng số thành các tensor số nguyên thực sự (INT8 hoặc INT4), đóng gói kèm metadata scale/zero-point và xuất ra các định dạng tối ưu cho suy luận như ExecuTorch (cho di động), TensorRT, hoặc vLLM.
Code minh họa thực tế với PyTorch (TorchAO)
Trong hệ sinh thái PyTorch hiện đại, thư viện chính chủ TorchAO (torchao) đã đơn giản hóa toàn bộ quy trình Prepare -> Train -> Convert chỉ gói gọn trong vài dòng code thông qua API quantize_:
Python
import torch
import torch.nn as nn
from torchao.quantization import Int4WeightOnlyConfig, quantize_
from torchao.quantization.qat import QATConfig

# 1. Khởi tạo mô hình gốc ở định dạng BF16
model = MyTransformerModel().to(device="cuda", dtype=torch.bfloat16)

# 2. Định nghĩa cấu hình nén đích (ví dụ: nén trọng số xuống INT4 theo nhóm 32)
base_config = Int4WeightOnlyConfig(group_size=32)

# Bước PREPARE: Chèn các lớp FakeQuantize vào mô hình để sẵn sàng train
quantize_(model, QATConfig(base_config, step="prepare"))

# 3. Vòng lặp huấn luyện QAT thông thường (sử dụng learning rate nhỏ)
optimizer = torch.optim.AdamW(model.parameters(), lr=2e-5)
loss_fn = nn.CrossEntropyLoss()

model.train()
for batch_inputs, batch_targets in train_dataloader:
    optimizer.zero_grad()
    # Forward pass tự động chạy qua các nút FakeQuant
    outputs = model(batch_inputs.to("cuda"))
    loss = loss_fn(outputs, batch_targets.to("cuda"))
    # Backward pass sử dụng Straight-Through Estimator (STE)
    loss.backward()
    optimizer.step()

# 4. Bước CONVERT: Loại bỏ FakeQuant, đóng gói thành mô hình INT4 thực sự để deploy
model.eval()
quantize_(model, QATConfig(base_config, step="convert"))
Điểm hay của kiến trúc này là phần vòng lặp huấn luyện (for batch_inputs...) hầu như không cần sửa đổi gì so với quy trình train PyTorch tiêu chuẩn—mọi phép giả lập làm tròn và truyền đạo hàm STE đều được xử lý ngầm bên trong các lớp tuyến tính đã được biến đổi.
QAT trong kỷ nguyên LLM: Khi kết hợp cùng LoRA
Trước đây, nhắc đến QAT với các mô hình ngôn ngữ lớn (LLM) là nhắc đến ác mộng về phần cứng vì bạn phải cập nhật toàn bộ hàng tỷ tham số cùng lúc. Tuy nhiên, sự ra đời của các kỹ thuật kết hợp QAT + LoRA (như QA-LoRA hoặc tích hợp TorchAO QAT trong Unsloth và Axolotl) đã thay đổi cuộc chơi.
Thay vì cập nhật toàn bộ trọng số gốc, hệ thống đóng băng mô hình chính, áp dụng FakeQuant lên trọng số gốc và chỉ huấn luyện các ma trận adapter LoRA nhỏ gọn nằm song song. Nhờ đó, bạn có thể chạy QAT cho các mô hình 4B–14B tham số ngay trên một chiếc GPU đơn lẻ (như RTX 4090 hoặc H100), giúp khôi phục tới 65%–70% lượng độ chính xác bị mất so với nén PTQ thông thường, đồng thời xuất thẳng ra điện thoại qua ExecuTorch mà không tốn thêm bất kỳ chi phí bộ nhớ nào lúc chạy.
4 nguyên tắc “sống còn” khi tự tay train QAT
- Hạ Learning Rate xuống mức thấp: Vì mô hình đã hội tụ từ trước, việc dùng learning rate quá lớn sẽ phá vỡ cấu trúc tri thức sẵn có. Mức khởi điểm an toàn thường bằng $1/10$ đến $1/5$ so với learning rate lúc fine-tune thông thường (ví dụ
1e-5hoặc2e-5cho LLM). - Chọn đúng kích thước nhóm (Group Size): Khi nén 4-bit, tham số
group_size(thường là 32, 64, hoặc 128) quyết định việc cứ bao nhiêu tham số thì dùng chung một hệ sốscale. Nhóm càng nhỏ thì độ chính xác càng cao nhưng tốn thêm một chút bộ nhớ lưu metadata. - Không nên trì hoãn FakeQuant quá lâu: Trong các quy trình QAT hiện đại cho mô hình lớn, việc bật FakeQuant ngay từ bước huấn luyện đầu tiên (
step 0) thường mang lại độ ổn định tốt hơn là train thường rồi mới bật giữa chừng. - Luôn đồng bộ sơ đồ nén giữa Train và Inference: Nếu thiết bị đích của bạn (như NPU trên điện thoại) chỉ hỗ trợ nhân số nguyên
INT8cho kích hoạt vàINT4cho trọng số (W4A8), bạn bắt buộc phải giả lập đúng chuẩnW4A8trong lúc QAT thay vì chỉ giả lập mỗi trọng số (W4A16).
Huấn luyện QAT đòi hỏi sự kiên nhẫn và tinh chỉnh kỹ lưỡng hơn nhiều so với việc chạy một dòng lệnh nén PTQ, nhưng thành quả mà nó mang lại là không thể thay thế. Khi ranh giới phần cứng ngày càng thu hẹp và nhu cầu đưa AI chạy trực tiếp trên thiết bị cá nhân bùng nổ, việc làm chủ quy trình QAT chính là kỹ năng giúp các kỹ sư AI biến những mô hình khổng lồ thành những sản phẩm thực tế mượt mà, tiết kiệm và đáng tin cậy.
Để xem cách triển khai vòng lặp huấn luyện QAT từng bước với bộ dữ liệu tùy chỉnh trong PyTorch, bạn có thể tham khảo video Hướng dẫn Quantization-Aware Training (QAT) với Custom DataLoader
.